Veel organisaties maken dagelijks back-ups van hun systemen en gegevens. Dat geeft een geruststellend gevoel. De back-upsoftware meldt dat de taak succesvol is afgerond, de bestanden zijn opgeslagen en er zijn geen fouten gerapporteerd.
Maar wat gebeurt er wanneer een belangrijk systeem morgen niet meer beschikbaar is? Kunt u uw gegevens daadwerkelijk terugzetten? Hoe lang duurt het voordat medewerkers weer kunnen werken? En wie bepaalt welke systemen als eerste moeten worden hersteld? Dat zijn andere vragen dan de vraag of de back-up is geslaagd.
Een succesvolle back-up betekent niet automatisch dat uw organisatie ook succesvol kan herstellen.
Waarom dit ertoe doet
IT-systemen zijn nauw verweven met de dagelijkse bedrijfsvoering. Medewerkers gebruiken applicaties, bestanden en communicatiemiddelen die voortdurend beschikbaar moeten zijn. Klanten verwachten dat bestellingen worden verwerkt, leveringen doorgaan en afspraken worden nagekomen. Wanneer een systeem uitvalt, ontstaat daardoor al snel meer dan een technisch probleem.
Een productiebedrijf kan bijvoorbeeld geen orders verwerken omdat het ERP-systeem niet beschikbaar is. Een handelsorganisatie kan geen leveringen voorbereiden. Medewerkers kunnen hun werkzaamheden niet voortzetten omdat bestanden of applicaties ontbreken. De gevolgen hangen niet alleen af van de storing zelf, maar vooral van de tijd die nodig is om de bedrijfsvoering te herstellen. Daarom begint een goed herstelplan niet bij de back-upsoftware, maar bij de organisatie.
Twee vragen die richting geven aan herstel
Bij het bepalen van een herstelstrategie zijn twee vragen bijzonder belangrijk.
1. Hoeveel gegevens kunt u maximaal verliezen?
Stel dat een systeem om 15.00 uur uitvalt en de laatste bruikbare back-up van middernacht is. Dan kan het betekenen dat alle wijzigingen van die werkdag opnieuw moeten worden ingevoerd of zelfs definitief verloren zijn. Voor sommige systemen is dat vervelend, maar beheersbaar. Voor andere processen kan het grote gevolgen hebben. Denk aan orderverwerking, financiële transacties, productiegegevens of wijzigingen in klantdossiers.
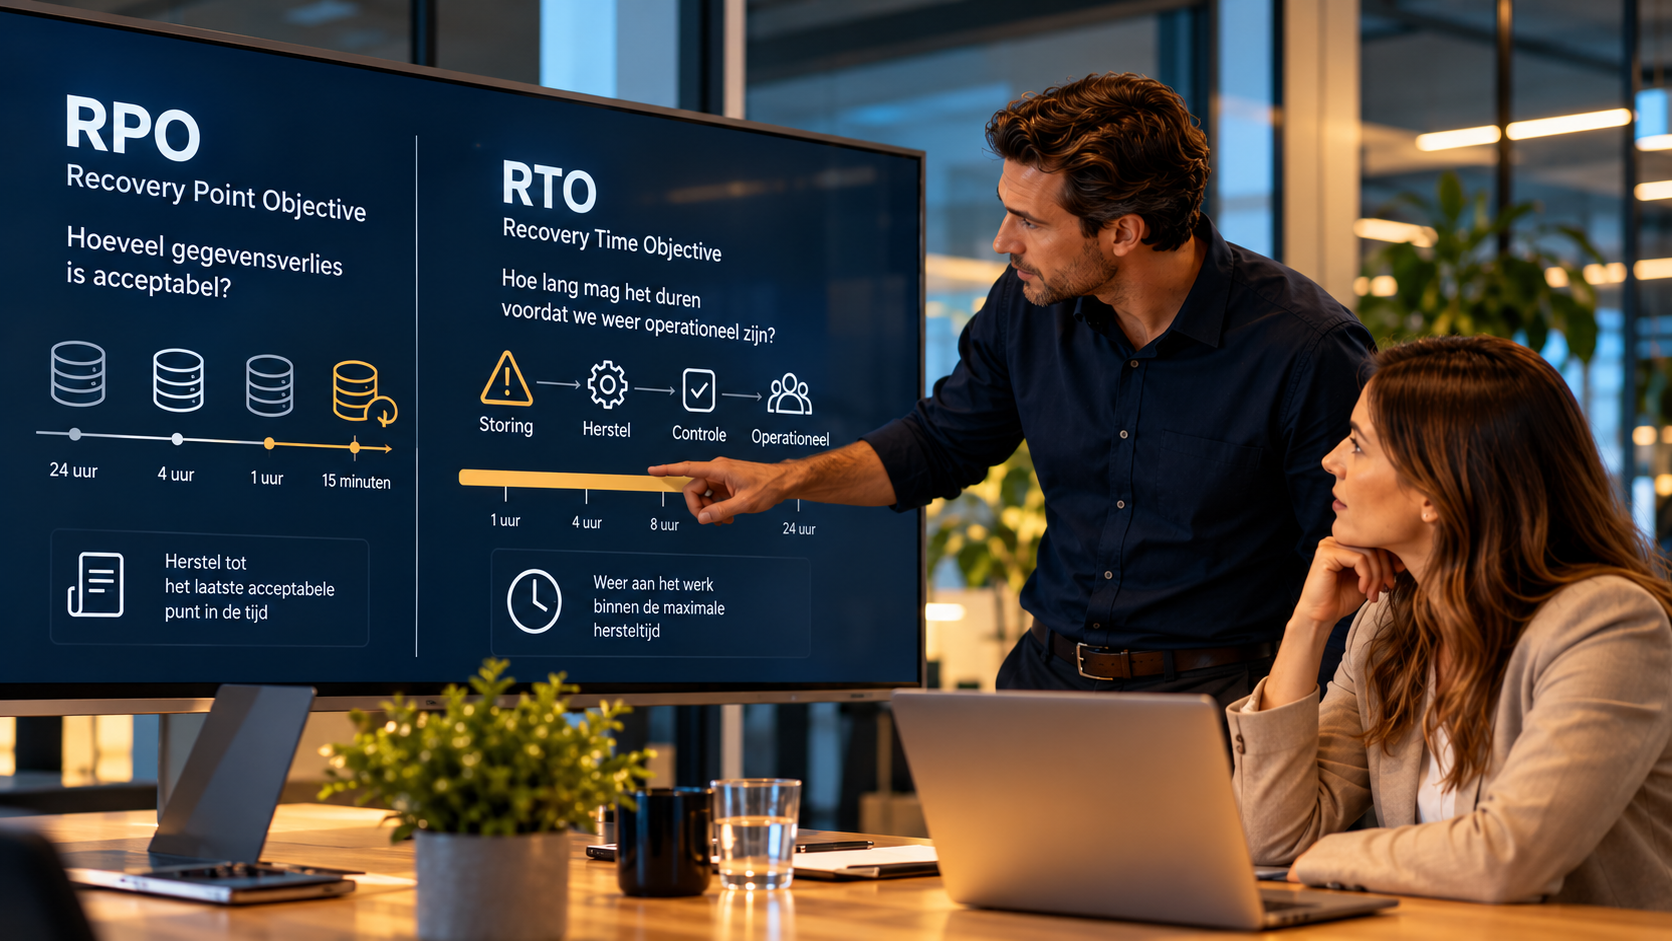
De maximale hoeveelheid gegevensverlies die een organisatie acceptabel vindt, wordt vaak aangeduid als de Recovery Point Objective (RPO). Een RPO van vier uur betekent dat de herstelvoorziening erop gericht moet zijn maximaal vier uur aan gegevenswijzigingen te verliezen. Maar of vier uur acceptabel is, kan alleen de organisatie zelf beoordelen.
2. Hoelang mag een systeem niet beschikbaar zijn?
Een tweede vraag is hoelang het mag duren voordat een systeem weer bruikbaar is. Een back-up terugzetten kan enkele minuten duren, maar ook vele uren of langer. Dat hangt onder andere af van de hoeveelheid gegevens, de beschikbare infrastructuur en de afhankelijkheden tussen systemen. Deze maximaal aanvaardbare hersteltijd wordt aangeduid als de Recovery Time Objective (RTO). Een RTO van vier uur betekent dat het herstelproces erop ingericht moet zijn de betreffende dienstverlening binnen vier uur te hervatten.
Dat is iets anders dan een garantie dat dit onder alle omstandigheden lukt. Het vraagt om passende voorzieningen, duidelijke afspraken en vooral om aantoonbaar geteste herstelprocedures.
OM OVER NA TE DENKEN
Als uw belangrijkste bedrijfsapplicatie morgenochtend niet beschikbaar is, hoeveel uur kan uw organisatie dan doorgaan voordat de gevolgen onacceptabel worden?
Herstellen is meer dan bestanden terugzetten
Bij herstel wordt vaak gedacht aan het terugzetten van bestanden of een virtuele server. In werkelijkheid is een bedrijfsapplicatie zelden een volledig zelfstandig systeem. Een applicatie kan afhankelijk zijn van een database, een identiteitsvoorziening, netwerkverbindingen, opslag, certificaten of diensten van externe leveranciers. Wanneer één van deze onderdelen ontbreekt, kan de applicatie technisch zijn hersteld terwijl medewerkers er nog steeds niet mee kunnen werken.
Neem een ERP-omgeving. Het herstellen van de applicatieserver heeft weinig waarde als de bijbehorende database niet beschikbaar is. En wanneer gebruikers niet kunnen aanmelden, blijft de omgeving praktisch onbruikbaar. Een bruikbare herstelstrategie kijkt daarom naar de volledige keten:
- Welke bedrijfsprocessen moeten als eerste worden hervat?
- Welke applicaties ondersteunen deze processen?
- Van welke systemen en externe diensten zijn deze applicaties afhankelijk?
- In welke volgorde moeten onderdelen worden hersteld?
- Welke medewerkers en leveranciers zijn daarbij nodig?
- Hoe controleren we dat de herstelde omgeving ook werkelijk functioneert?
Juist die samenhang bepaalt of een herstelplan in de praktijk werkt.
Vier stappen naar aantoonbaar herstel
Prioriteren
de organisatie bepaalt
Benoem kritieke bedrijfsprocessen en stel per proces het acceptabele gegevensverlies (RPO) en de maximale hersteltijd (RTO) vast. Wijs een eigenaar aan die herstelprioriteiten en tijdelijke werkwijzen kan goedkeuren.
Voorbereiden
IT en leveranciers richten in
Vertaal de doelen naar beveiligde back-ups, beschikbare herstelvoorzieningen en een uitvoerbare herstelvolgorde. Leg afhankelijkheden, benodigde toegang, contactpersonen en afspraken tussen leveranciers vast.
Herstellen
de herstelcoördinator voert regie
Laat betrokken partijen volgens het plan samenwerken en de benodigde keten herstellen. Bewaak tijd en beslismomenten; de organisatie bepaalt wanneer tijdelijke maatregelen of andere prioriteiten nodig zijn.
Toetsen
gebruikers en IT controleren
Test of gegevens bruikbaar zijn en medewerkers het bedrijfsproces kunnen hervatten. Meet gegevensverlies en hersteltijd, vergelijk deze met RPO en RTO en leg verbeteringen en een volgende test vast.
De organisatie bepaalt wat herstel moet opleveren; IT en leveranciers maken het uitvoerbaar. Een werkende applicatie is pas voldoende wanneer het bijbehorende bedrijfsproces weer bruikbaar is.
Een back-up die niet getest is, blijft een aanname
Back-upsoftware kan doorgaans goed vaststellen of gegevens volgens de ingestelde procedure zijn opgeslagen. Dat zegt echter niet alles over de bruikbaarheid van die gegevens. Bestanden kunnen bijvoorbeeld correct zijn gekopieerd, terwijl een applicatie na herstel niet start. Een database kan worden teruggezet, maar niet aansluiten op andere onderdelen van de omgeving. Ook kan blijken dat herstel veel langer duurt dan vooraf werd aangenomen. Daarom is periodiek testen essentieel.
Wat moet u dan testen?
Niet iedere test hoeft een volledige uitwijktest van de hele organisatie te zijn. Een praktische aanpak kan uit verschillende niveaus bestaan:
- Bestandsherstel: controleer of afzonderlijke bestanden correct kunnen worden teruggezet.
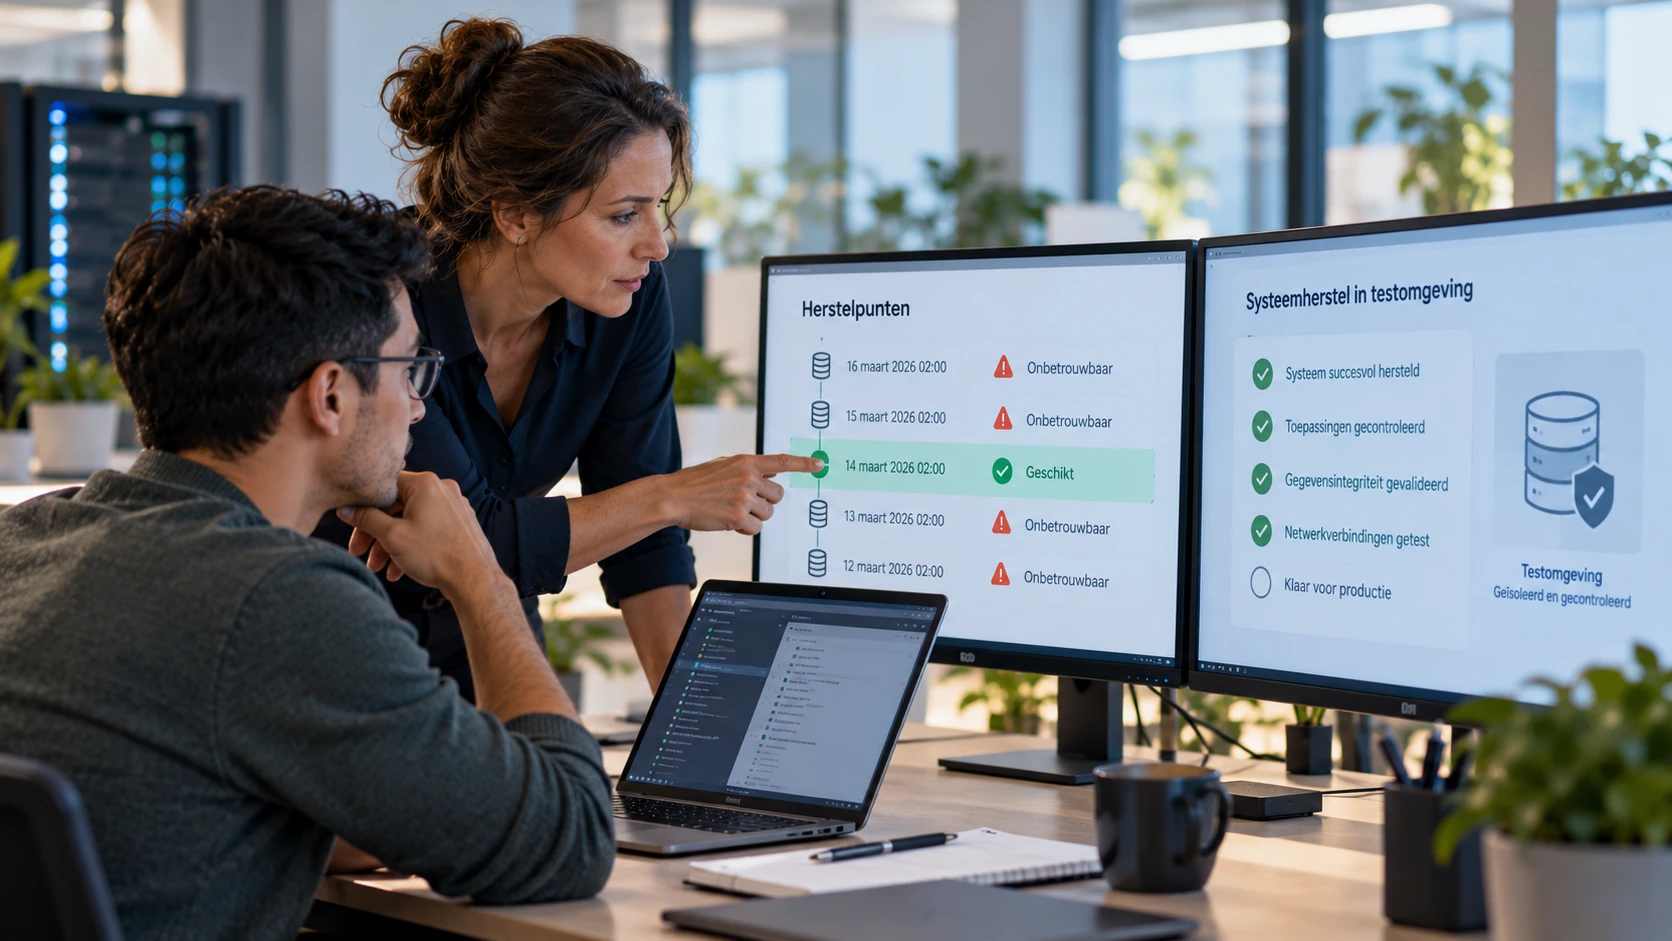
- Systeemherstel: herstel een server of werkplek in een geschikte testomgeving.
- Applicatieherstel: controleer of een applicatie inclusief de benodigde gegevens daadwerkelijk functioneert.
- Ketenherstel: test of samenwerkende systemen en afhankelijkheden in de juiste volgorde kunnen worden hersteld.
- Procesherstel: laat gebruikers beoordelen of zij hun werkzaamheden na herstel daadwerkelijk kunnen hervatten.
De uitkomsten van deze tests maken zichtbaar waar aannames niet overeenkomen met de praktijk. Een hersteltest is daarmee niet alleen een technische controle, maar ook een manier om bedrijfsrisico's concreet te beoordelen.
Illustratief praktijkvoorbeeld
ERP-herstel bij een productiebedrijf
Situatie. In een hersteltest simuleert een productiebedrijf dat zijn ERP-systeem om 09.00 uur uitvalt. Orderverwerking en productieplanning liggen stil. Voor dit proces heeft de organisatie een RPO van één uur en een RTO van vier uur vastgesteld.
- Aanpak
De herstelcoördinator stemt de werkzaamheden af tussen de IT-beheerder en de ERP-leverancier. Zij controleren het bruikbare herstelpunt en herstellen de benodigde netwerk- en identiteitsvoorzieningen, database, applicatie en koppelingen in de vastgelegde volgorde. Medewerkers registreren nieuwe orders tijdelijk volgens een afgesproken noodprocedure.
- Controle
In een afgeschermde testomgeving controleren gebruikers het aanmelden, bestaande orders, de planning en een volledige orderverwerking. Het bruikbare herstelpunt is van 08.30 uur: dertig minuten gegevenswijzigingen ontbreken. Om 12.15 uur is het geteste proces weer bruikbaar: drie uur en vijftien minuten na de gesimuleerde uitval. Beide uitkomsten vallen binnen de vastgestelde doelen.
- Hervatting
De proceseigenaar beoordeelt of het proces voldoende werkt en welke controles vóór vrijgave nodig zijn. Het team oefent ook het gecontroleerd verwerken van tijdelijk geregistreerde orders, voorkomt dubbeltellingen en legt verbeterpunten en een volgende test vast.
Kernles: een teruggezette ERP-server bewijst nog geen bedrijfscontinuïteit. Pas de controle van de volledige keten, de gemeten RPO/RTO-uitkomsten en de hervatting van het werk maken herstel aantoonbaar. Deze testuitkomst is geen garantie voor ieder incident.
Dit is een fictieve situatie ter illustratie, geen beschrijving van een klantcase of een door Malenco behaald resultaat. De tijden en doelen zijn uitsluitend gekozen voor dit voorbeeld.
Wat als de back-up zelf wordt getroffen?
Bij een ernstig beveiligingsincident, bijvoorbeeld ransomware, kan niet alleen de productieomgeving worden geraakt. Ook back-upvoorzieningen kunnen doelwit zijn. Wanneer back-ups bereikbaar zijn met dezelfde beheerdersaccounts of onvoldoende zijn afgeschermd van de productieomgeving, kan een aanvaller mogelijk ook herstelgegevens verwijderen of versleutelen. Daarom vraagt een betrouwbare back-upstrategie aandacht voor de beveiliging van de back-ups zelf. Belangrijke maatregelen zijn onder andere:
- Gescheiden toegang en beheer van back-upvoorzieningen.
- Beperkte beheerdersrechten en sterke authenticatie.
- Back-ups die niet eenvoudig gewijzigd of verwijderd kunnen worden.
- Een passende combinatie van lokale en externe opslag.
- Bewaking van back-upresultaten en afwijkingen.
- Periodieke controles op de beschikbaarheid en integriteit van herstelgegevens.
Welke maatregelen noodzakelijk zijn, hangt af van de risico's, de inrichting van de IT-omgeving en de eisen aan bedrijfscontinuïteit. Het gaat niet om zoveel mogelijk back-ups maken, maar om de zekerheid dat er na een incident nog een bruikbare herstelmogelijkheid bestaat.
Wie is verantwoordelijk wanneer herstel nodig is?
In veel organisaties zijn verschillende partijen betrokken bij de IT-omgeving. De ene leverancier beheert de infrastructuur, een andere ondersteunt de bedrijfsapplicatie en een derde verzorgt de back-upvoorziening. Zolang alles functioneert, hoeft die verdeling geen probleem te zijn. Maar bij een incident ontstaat een belangrijke vraag: wie voert de regie? Wie stelt vast welke systemen eerst moeten worden hersteld? Wie stemt de werkzaamheden tussen leveranciers af? En wie beoordeelt of de bedrijfsvoering weer voldoende functioneert?
Zonder duidelijke afspraken kan kostbare tijd verloren gaan, zelfs wanneer alle betrokken partijen hun eigen werkzaamheden goed uitvoeren. Een herstelplan moet daarom niet alleen technische stappen bevatten, maar ook verantwoordelijkheden, contactgegevens, escalatieafspraken en beslismomenten. De verantwoordelijkheid voor bedrijfscontinuïteit kan niet volledig worden overgedragen aan back-upsoftware of een IT-leverancier. De organisatie moet zelf bepalen welke gevolgen acceptabel zijn en welke herstelprioriteiten daarbij horen.
Van een back-upstrategie naar aantoonbare herstelbaarheid
Een organisatie die grip wil krijgen op haar herstelmogelijkheden, hoeft niet direct een omvangrijk project te starten. Het begint met inzicht. Welke systemen zijn werkelijk kritisch? Wat zijn de gevolgen wanneer deze systemen uitvallen? Welke back-ups zijn beschikbaar en wanneer zijn die voor het laatst succesvol getest? Vervolgens kunnen de technische voorzieningen en herstelprocedures worden beoordeeld tegen de eisen van de organisatie. Daaruit ontstaat een praktische aanpak:
- Breng kritieke bedrijfsprocessen en afhankelijkheden in kaart.
- Bepaal per proces het acceptabele gegevensverlies en de hersteltijd.
- Controleer of de bestaande back-upvoorzieningen hierbij aansluiten.
- Leg de herstelvolgorde en verantwoordelijkheden vast.
- Test het herstel onder realistische omstandigheden.
- Gebruik de testresultaten om voorzieningen en procedures te verbeteren.
Een herstelplan is daarbij geen eenmalig document. Applicaties veranderen, gegevensvolumes groeien, medewerkers wisselen en leveranciers passen hun dienstverlening aan. Daarom moeten herstelvoorzieningen en afspraken periodiek opnieuw worden beoordeeld.
De vraag is niet of u een back-up heeft
Een back-up is een noodzakelijke voorziening, maar geen zelfstandig bewijs van bedrijfscontinuïteit. De werkelijke waarde blijkt pas wanneer systemen uitvallen en de organisatie afhankelijk wordt van haar herstelmogelijkheden. Dan telt niet alleen of de gegevens nog bestaan, maar ook of de juiste systemen, mensen en procedures beschikbaar zijn om de bedrijfsvoering te hervatten. Een betrouwbare herstelstrategie verbindt daarom techniek met bedrijfsprocessen, risico's en verantwoordelijkheden. De belangrijkste vraag is uiteindelijk niet of we back-ups maken, maar of we weten hoe en binnen welke tijd we weer verder kunnen.