Een internetverbinding valt weg, een switch raakt defect of een server stopt onverwacht met functioneren. In een goed ingerichte IT-omgeving hoeft zo'n storing niet direct gevolgen te hebben voor de bedrijfsvoering. Een alternatieve voorziening kan de functie overnemen, zodat medewerkers en bedrijfsprocessen zoveel mogelijk kunnen doorgaan. Dat klinkt vanzelfsprekend, maar in de praktijk is het realiseren van een betrouwbare infrastructuur ingewikkelder dan het simpelweg dubbel uitvoeren van apparatuur.
Twee internetverbindingen bieden bijvoorbeeld niet automatisch zekerheid wanneer ze via dezelfde fysieke route lopen. Twee servers kunnen elkaar niet helpen als ze afhankelijk zijn van dezelfde defecte opslagvoorziening. En een tweede firewall heeft weinig waarde wanneer de omschakeling niet goed is ingericht. Redundantie draait daarom niet uitsluitend om het beschikbaar hebben van reserveapparatuur, maar vooral om het herkennen en beperken van kwetsbare afhankelijkheden. Het doel is dat een storing in één onderdeel niet onnodig leidt tot het uitvallen van een volledig bedrijfsproces.
Beschikbaarheid begint bij de gevolgen van uitval
Niet iedere IT-voorziening hoeft voortdurend beschikbaar te zijn. Wanneer een interne rapportageomgeving een uur niet bereikbaar is, kan dat vervelend zijn zonder dat het werk direct stilvalt. Bij een productiesysteem, een logistieke applicatie of de internetverbinding van een volledig bedrijf kan dezelfde uitval veel grotere gevolgen hebben. Daarom begint een goede beschikbaarheidsstrategie niet bij de keuze voor apparatuur, maar bij de vraag welke bedrijfsprocessen afhankelijk zijn van welke IT-voorzieningen.
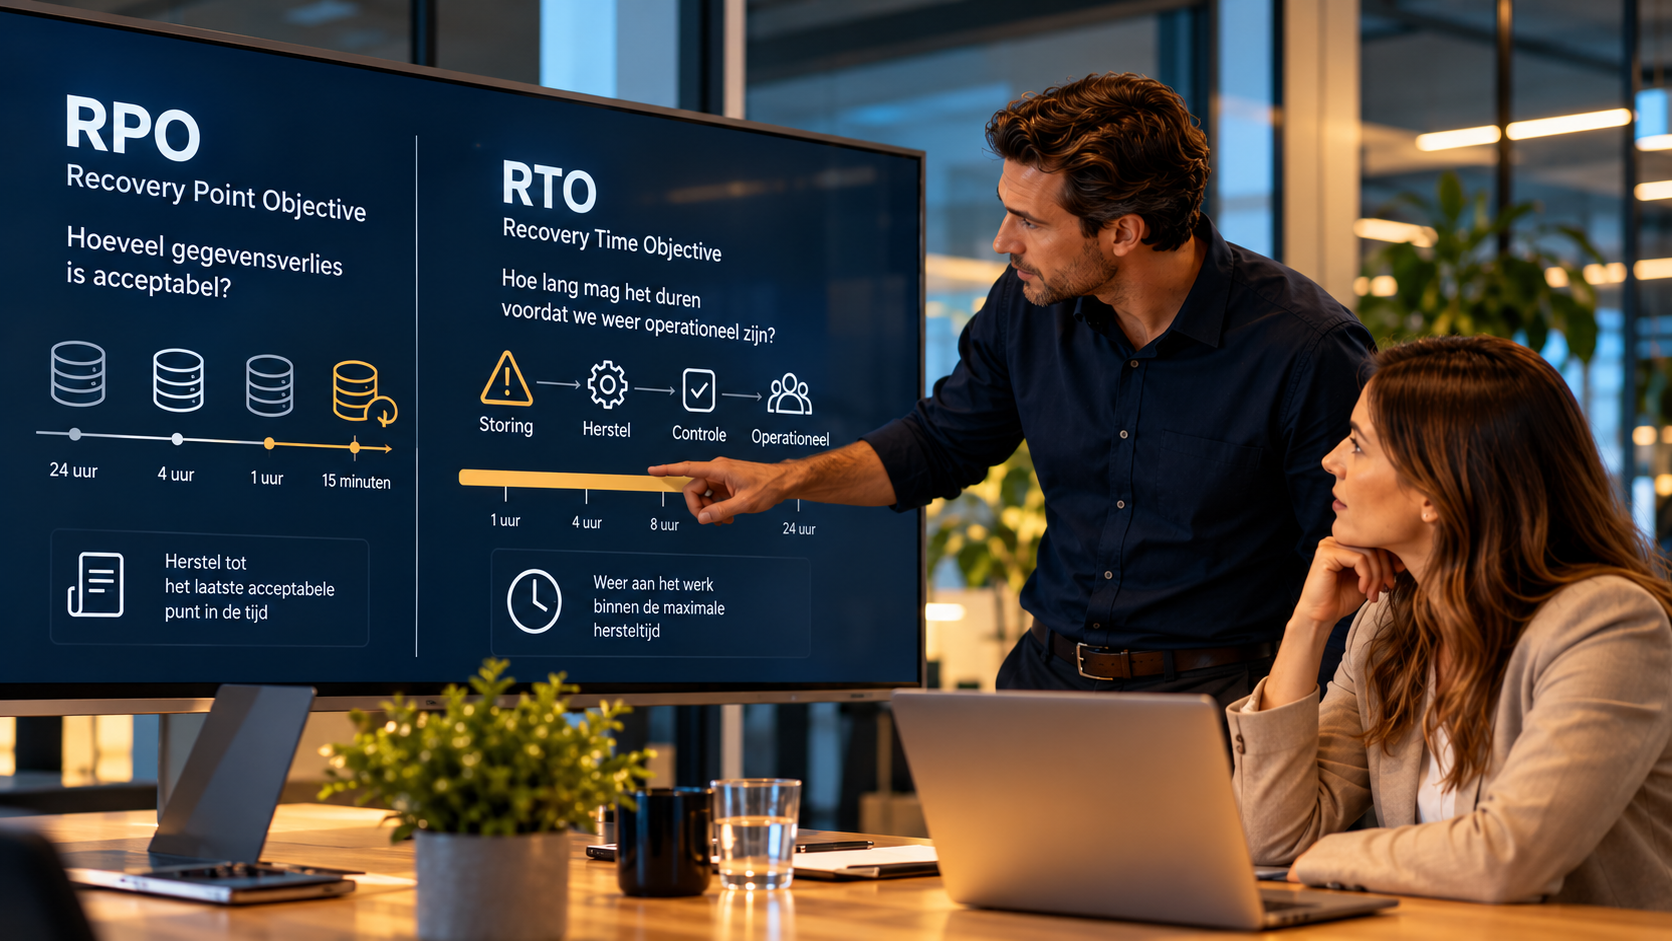
Welke systemen zijn noodzakelijk om orders te verwerken? Wat gebeurt er wanneer medewerkers geen toegang meer hebben tot hun applicaties? Hoe lang kan een productieproces doorgaan zonder verbinding met het centrale systeem? En welke voorzieningen moeten onmiddellijk beschikbaar blijven, ook wanneer een onderdeel defect raakt? De antwoorden op deze vragen bepalen waar redundantie noodzakelijk is, welke vorm passend is en hoeveel onderbreking de organisatie kan accepteren. Een omgeving waarin enkele minuten uitval aanvaardbaar zijn, stelt immers andere eisen dan een proces dat vrijwel zonder onderbreking moet kunnen doorgaan.
Redundantie, failover en beschikbaarheid zijn niet hetzelfde
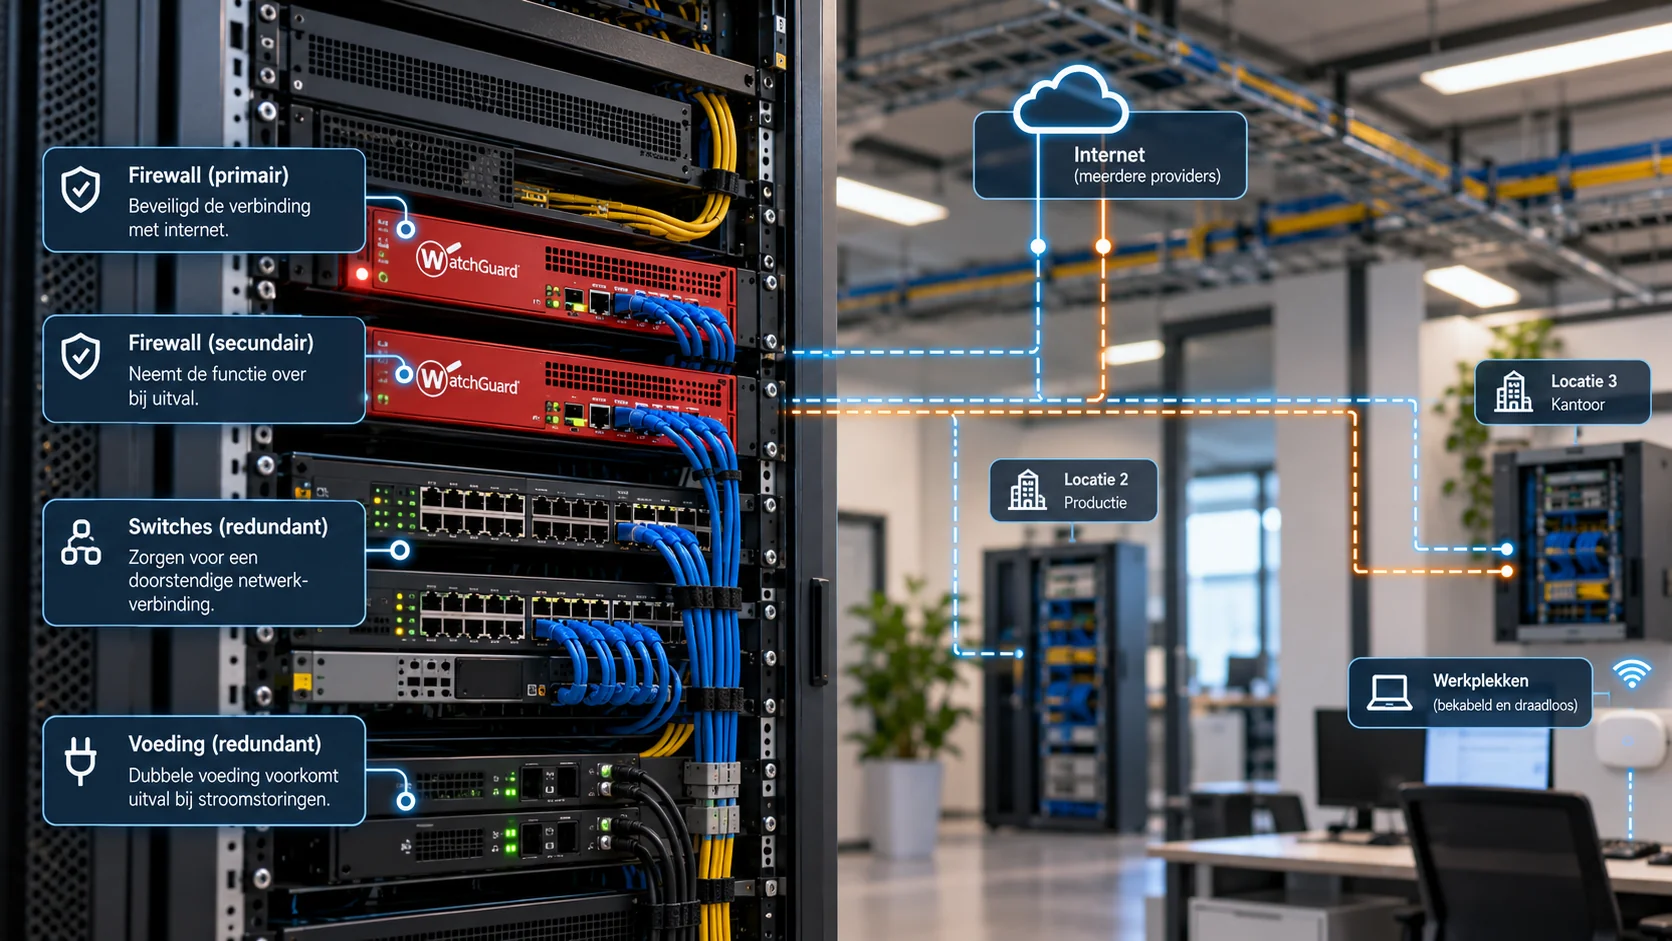
Hoewel deze begrippen vaak in één adem worden genoemd, beschrijven ze verschillende onderdelen van een betrouwbare IT-infrastructuur. Bij redundantie wordt een kritieke functie zo ingericht dat er een alternatieve voorziening aanwezig is. Dat gebeurt vaak door apparatuur dubbel uit te voeren, bijvoorbeeld met twee switches, twee firewalls, meerdere servers of een tweede internetverbinding. Ook gescheiden netwerkpaden, meerdere voedingen en redundant uitgevoerde opslag kunnen hier onderdeel van zijn. Het uitgangspunt is dat het defect raken van één onderdeel niet automatisch leidt tot het wegvallen van de functie die dat onderdeel vervult.
Failover is het mechanisme waarmee de alternatieve voorziening de functie van de primaire voorziening overneemt. Dat kan automatisch gebeuren, bijvoorbeeld wanneer een firewallcluster een defect apparaat detecteert, maar in andere situaties kan handmatige tussenkomst nodig zijn. Hoe snel en betrouwbaar die overname plaatsvindt, is minstens zo belangrijk als de aanwezigheid van de reservevoorziening. Een organisatie kan dus redundante apparatuur hebben zonder dat een storing automatisch of zonder merkbare onderbreking wordt opgevangen.
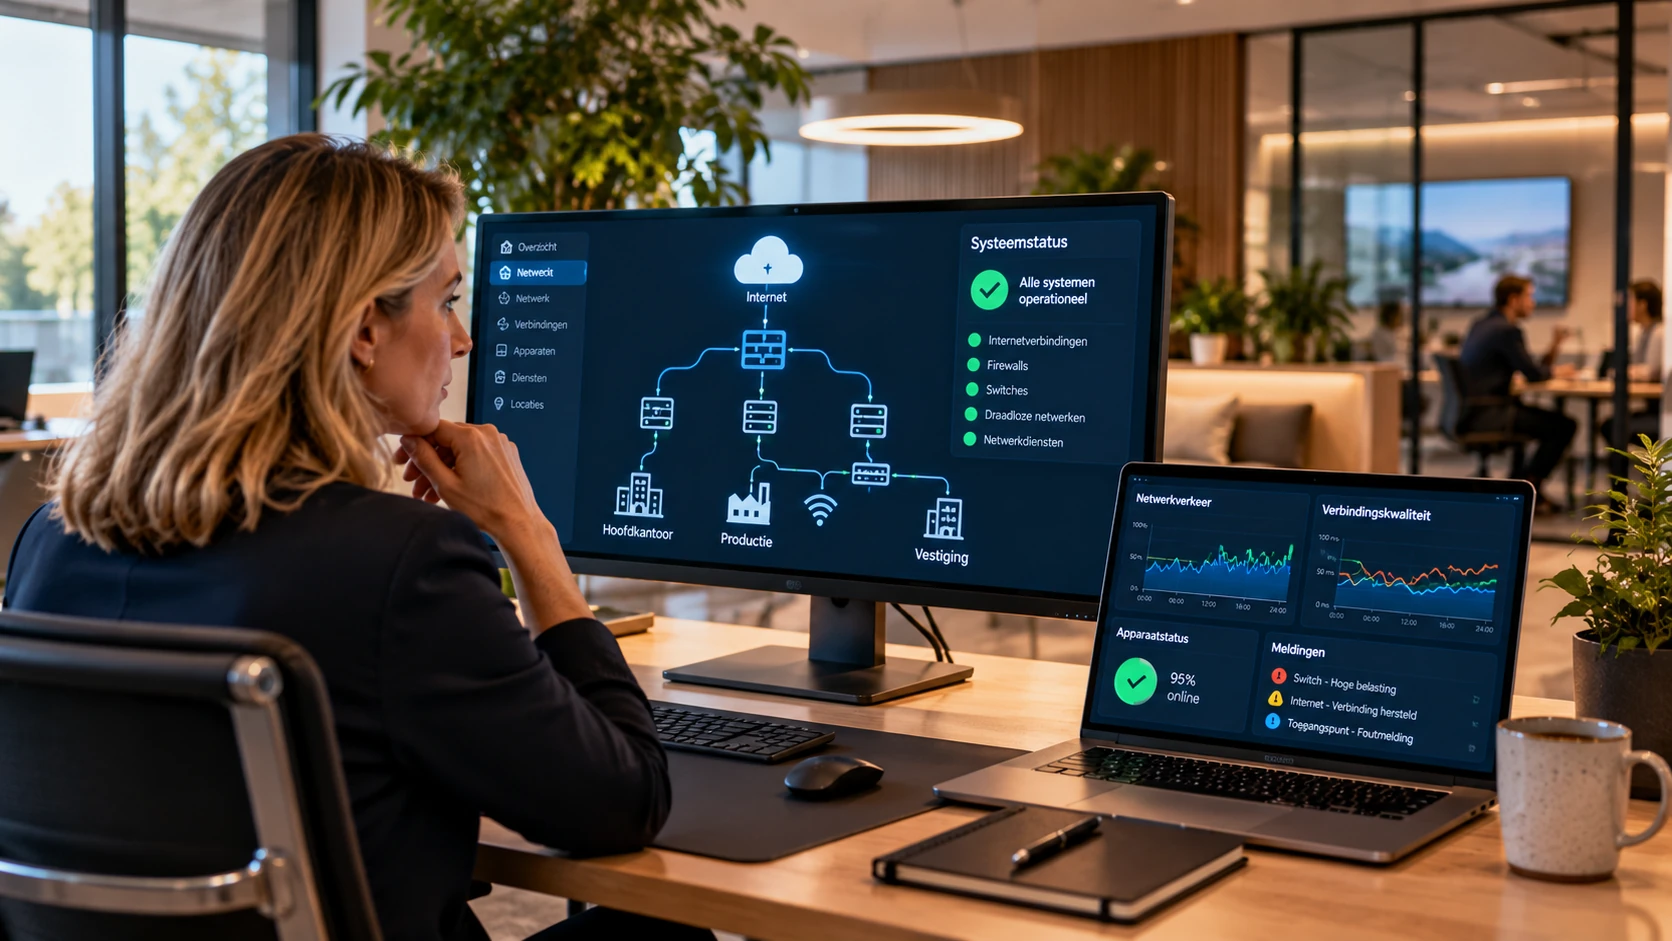
Uiteindelijk draait het om beschikbaarheid: kunnen medewerkers en bedrijfsprocessen blijven functioneren? Een tweede internetverbinding kan succesvol actief worden terwijl bestaande sessies toch worden verbroken. Een applicatie kan op een andere server starten, maar pas na enige tijd weer volledig bruikbaar zijn. Ook kan een systeem technisch bereikbaar zijn terwijl een noodzakelijke koppeling met een ander systeem ontbreekt. Daarom moet de werking van redundantie worden beoordeeld vanuit de volledige dienstverlening en niet uitsluitend vanuit de status van afzonderlijke apparaten.
Redundantie vraagt meer dan apparatuur dubbel uitvoeren
Dubbele apparatuur is een belangrijk middel om storingen op te vangen, maar een redundant ontwerp is pas effectief wanneer ook de afhankelijkheden rondom die apparatuur worden meegenomen. Een netwerk kan bijvoorbeeld beschikken over twee centrale switches die elkaars functie kunnen overnemen. Wanneer beide switches echter op dezelfde stroomgroep zijn aangesloten, kan één stroomstoring alsnog het volledige netwerk uitschakelen. De switches zijn dubbel uitgevoerd, maar hun stroomvoorziening vormt nog steeds een kwetsbaar punt.
Hetzelfde geldt voor twee internetverbindingen die via dezelfde kabelroute het gebouw binnenkomen. Ondanks de aanwezigheid van twee providers kan één beschadiging aan de bekabeling beide verbindingen onderbreken. Ook binnen serveromgevingen komen dergelijke afhankelijkheden voor. Twee servers kunnen elkaars taken overnemen, maar wanneer beide afhankelijk zijn van één opslagvoorziening, kan uitval van die opslag alsnog de volledige dienstverlening raken. Het ontwerp moet daarom niet alleen rekening houden met de afzonderlijke apparaten, maar ook met de verbindingen, stroomvoorzieningen en andere voorzieningen waarvan zij afhankelijk zijn.
Daarbij zijn niet alle risico's fysiek. Twee firewalls in een high-availabilityconfiguratie kunnen uitstekend beschermen tegen het defect raken van één apparaat. Wanneer echter een foutieve configuratie naar beide firewalls wordt verspreid, kan diezelfde fout beide apparaten treffen. Redundantie beschermt in dat geval tegen bepaalde hardwarestoringen, maar niet noodzakelijk tegen configuratiefouten. De relevante vraag is daarom niet alleen of een onderdeel dubbel is uitgevoerd, maar vooral welke storingen beide voorzieningen tegelijkertijd kunnen raken.
Hoe verloopt een failover in de praktijk?
Wanneer een primaire voorziening uitvalt, moet de infrastructuur de storing herkennen en bepalen of de alternatieve voorziening de functie moet overnemen. Wat daarna gebeurt, verschilt per omgeving en per techniek. Bij sommige systemen vindt de omschakeling volledig automatisch plaats, terwijl bij andere voorzieningen een beheerder moet ingrijpen. In grote lijnen zijn vier fasen te onderscheiden.
Storing detecteren.
Het systeem stelt vast dat de primaire voorziening niet meer naar behoren functioneert. Daarbij is het belangrijk dat niet alleen wordt gecontroleerd of een apparaat nog aanstaat, maar ook of de noodzakelijke dienst daadwerkelijk werkt.Overschakelen naar het alternatief.
De alternatieve voorziening neemt de functie over. Afhankelijk van de inrichting kan dit automatisch plaatsvinden of een beheerhandeling vereisen. Tijdens de omschakeling kunnen bestaande verbindingen tijdelijk worden onderbroken.De werking controleren.
Na de overname moet blijken of de betrokken diensten en applicaties daadwerkelijk functioneren. Een succesvolle technische omschakeling betekent immers niet automatisch dat medewerkers zonder problemen verder kunnen werken.Terugkeren naar de normale situatie.
Wanneer de oorspronkelijke voorziening is hersteld, wordt bepaald of en wanneer terugschakelen verstandig is. Dat hoeft niet direct of automatisch te gebeuren. Soms voorkomt een geplande terugschakeling juist een tweede verstoring.
Deze fasen vormen geen universeel technisch stappenplan, maar laten zien dat een betrouwbare failover niet eindigt bij het activeren van een reservevoorziening. Ook controle, herstel en beheer zijn onderdeel van het proces. Vooral het terugschakelen verdient aandacht, omdat een te snelle terugkeer naar een nog instabiele primaire voorziening opnieuw tot onderbrekingen kan leiden.
Automatische omschakeling is niet altijd noodzakelijk
Bij redundantie wordt vaak gedacht aan systemen die zonder menselijke tussenkomst overschakelen. Voor bedrijfskritische voorzieningen kan dat noodzakelijk zijn, maar niet iedere dienst vraagt om dezelfde aanpak. Een korte onderbreking van enkele seconden kan bij bepaalde toepassingen al problematisch zijn, terwijl andere systemen enkele minuten of langer niet beschikbaar mogen zijn zonder dat dit grote gevolgen heeft. De gewenste beschikbaarheid moet daarom worden afgestemd op het bedrijfsproces dat wordt ondersteund.
Automatische failover kan de hersteltijd sterk verkorten, maar vraagt ook om zorgvuldige configuratie en controle. Een systeem moet bijvoorbeeld voorkomen dat het voortdurend tussen twee voorzieningen wisselt wanneer een verbinding instabiel is. In andere situaties kan een gecontroleerde handmatige omschakeling juist passend zijn, bijvoorbeeld wanneer een alternatieve omgeving eerst moet worden gecontroleerd of wanneer de gevolgen van een verkeerde omschakeling groter zijn dan die van een korte onderbreking. Het gaat er niet om dat iedere voorziening zo snel mogelijk overschakelt, maar dat de gekozen werkwijze past bij de risico's en continuïteitseisen van de organisatie.
Een redundante infrastructuur moet ook worden getest
Een redundante voorziening die nooit wordt getest, biedt minder zekerheid dan op papier lijkt. Apparatuur kan jarenlang probleemloos functioneren terwijl ongemerkt een afhankelijkheid ontstaat die de omschakeling belemmert. Een configuratiewijziging kan ervoor zorgen dat een tweede verbinding niet meer goed werkt, terwijl een alternatieve server wel beschikbaar is maar niet beschikt over alle instellingen die nodig zijn om een applicatie over te nemen. Zulke problemen worden soms pas zichtbaar wanneer de primaire voorziening daadwerkelijk uitvalt.
Daarom hoort het testen van redundantie bij regulier IT-beheer. Dat betekent niet dat iedere voorziening voortdurend bewust moet worden uitgeschakeld, maar wel dat periodiek wordt vastgesteld of de alternatieve route of voorziening beschikbaar is, of de omschakeling werkt zoals bedoeld en of de betrokken diensten daarna bruikbaar blijven. Ook wijzigingen verdienen aandacht. Wanneer een nieuwe applicatie, netwerkverbinding of afhankelijkheid wordt toegevoegd, kan dat gevolgen hebben voor de bestaande redundante inrichting. Een beschikbaarheidsontwerp blijft alleen betrouwbaar wanneer het meegroeit met de IT-omgeving en de werking ervan regelmatig wordt gecontroleerd.
Welke onderdelen moeten redundant worden uitgevoerd?
Het is technisch mogelijk om veel onderdelen van een infrastructuur dubbel uit te voeren, maar dat betekent niet dat dit voor iedere organisatie verstandig of noodzakelijk is. Redundantie brengt kosten met zich mee, zowel bij aanschaf als in beheer. Bovendien kan extra complexiteit nieuwe risico's introduceren wanneer de inrichting onvoldoende wordt beheerst. De keuze moet daarom worden gemaakt op basis van het belang van de dienst, de gevolgen van uitval en de tijd waarbinnen de dienstverlening moet kunnen worden hervat.
Bij een organisatie die vrijwel volledig afhankelijk is van cloudapplicaties kan de internetverbinding een bijzonder kritieke voorziening zijn. In een productieomgeving kunnen juist de verbindingen tussen machines, besturingssystemen en centrale applicaties bepalend zijn voor de continuïteit. Ook binnen één organisatie kunnen de eisen sterk verschillen. Sommige bedrijfsprocessen vereisen vrijwel onmiddellijke overname, terwijl bij andere processen een gecontroleerd herstel binnen een afgesproken periode voldoende is. Het uitgangspunt is niet om overal dezelfde mate van redundantie toe te passen, maar om de beschikbaarheid af te stemmen op wat de organisatie daadwerkelijk nodig heeft.
Redundantie is onderdeel van een bredere continuïteitsaanpak
Redundantie helpt om bepaalde storingen op te vangen, maar is geen vervanging voor back-up en herstel. Wanneer een server defect raakt, kan een tweede server de dienstverlening overnemen. Maar wanneer gegevens worden verwijderd, beschadigd raken of door ransomware worden versleuteld, kan diezelfde schade zich ook voordoen op de alternatieve voorziening. Daarvoor zijn andere maatregelen nodig, zoals passende back-ups, herstelprocedures en mogelijkheden om systemen en gegevens naar een betrouwbare toestand terug te brengen.
Een goede continuïteitsaanpak combineert daarom verschillende maatregelen. Redundantie beperkt de gevolgen van uitval van onderdelen, failover verzorgt de overname wanneer dat nodig is en back-up en herstel maken het mogelijk om terug te keren naar een bruikbare situatie wanneer beschikbaarheid alleen niet voldoende bescherming biedt. Die maatregelen vullen elkaar aan, maar hebben ieder een eigen functie. Door ze in samenhang te ontwerpen, ontstaat een infrastructuur die niet alleen bestand is tegen het defect raken van apparatuur, maar ook voorbereid is op andere verstoringen van de bedrijfsvoering.
Betrouwbare IT vraagt om inzicht in afhankelijkheden
De waarde van redundantie wordt pas duidelijk wanneer bekend is welke voorzieningen van elkaar afhankelijk zijn en wat er gebeurt wanneer één daarvan uitvalt. Dat vraagt om meer dan een overzicht van aanwezige apparatuur. Het vraagt om inzicht in netwerkverbindingen, stroomvoorzieningen, applicaties, opslag, externe diensten en de manier waarop bedrijfsprocessen daarvan gebruikmaken. Vanuit dat inzicht kan worden bepaald waar een tweede voorziening noodzakelijk is, hoe de omschakeling moet functioneren en welke controles nodig zijn om de werking betrouwbaar te houden.
Een goed redundant ontwerp is daarmee geen verzameling dubbele apparaten, maar een bewuste inrichting van de IT-infrastructuur rondom de continuïteit van de organisatie. Het doel is niet om zoveel mogelijk apparatuur dubbel uit te voeren, maar om ervoor te zorgen dat een storing in één onderdeel niet onnodig leidt tot stilstand van de organisatie.