Een medewerker kan niet meer bij zijn bestanden, een beheerdersaccount vertoont ongebruikelijke activiteiten of een beveiligingssysteem meldt dat een server mogelijk is aangevallen. Op dat moment is vaak nog niet duidelijk wat er precies aan de hand is. Toch kunnen de beslissingen in de eerste uren bepalend zijn voor de gevolgen. Moet een systeem direct worden afgesloten? Welke andere systemen kunnen betrokken zijn? En wie mag besluiten om een bedrijfskritische applicatie tijdelijk buiten gebruik te stellen?
Incidentrespons gaat over het georganiseerd omgaan met dit soort situaties. Niet alleen door technische maatregelen te nemen, maar ook door verantwoordelijkheden vast te leggen, gevolgen voor de bedrijfsvoering af te wegen en herstel zorgvuldig uit te voeren.
Van beveiligingsmelding naar incident
Beveiligingssystemen registreren voortdurend gebeurtenissen. Een mislukte aanmelding, een verdacht proces of een ongebruikelijke netwerkverbinding kan wijzen op een aanval, maar kan ook een legitieme verklaring hebben. Daarom begint incidentrespons met een beoordeling van wat er daadwerkelijk is waargenomen, welke systemen en accounts betrokken zijn en of er aanwijzingen bestaan voor onbevoegde toegang, gegevensverlies of verstoring.
Niet iedere melding vraagt om dezelfde reactie. Een verdachte activiteit op één werkplek kan soms beperkt blijven tot nader onderzoek, terwijl aanwijzingen dat een aanvaller beheerrechten heeft verkregen onmiddellijk ingrijpen noodzakelijk kunnen maken. Het doel is om snel onderscheid te maken tussen een onschuldige gebeurtenis, een beveiligingsprobleem dat aandacht vraagt en een incident waarbij verdere schade moet worden voorkomen.
Daarbij is de samenhang met securitymonitoring belangrijk. Monitoring helpt om afwijkingen te herkennen en te beoordelen; incidentrespons zorgt ervoor dat bij een vermoedelijke of vastgestelde dreiging de juiste maatregelen worden genomen.
Voorbereiding bepaalt hoe snel een organisatie kan handelen
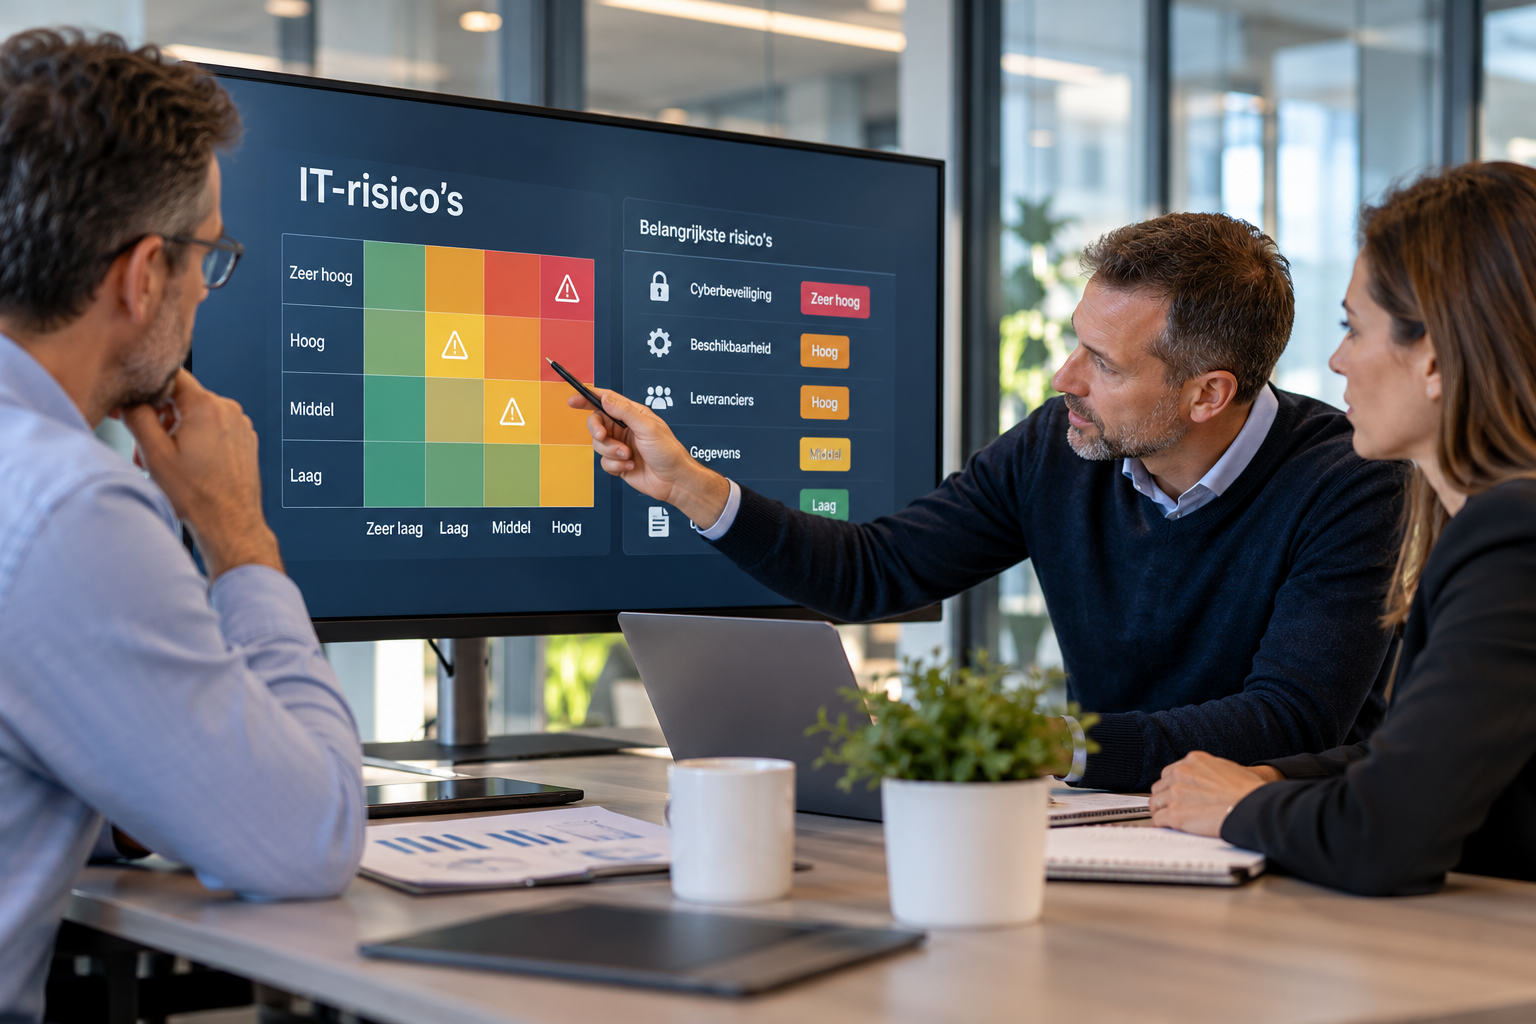
Wanneer een incident zich voordoet, is er meestal weinig tijd om verantwoordelijkheden en procedures nog uit te zoeken. Toch zijn juist die organisatorische vragen belangrijk. Wie is bereikbaar buiten kantooruren? Wie beschikt over de noodzakelijke beheerrechten? Welke systemen zijn essentieel voor de bedrijfsvoering? En wie mag besluiten dat een productieproces tijdelijk wordt stilgelegd?
Een organisatie die deze vragen vooraf heeft beantwoord, kan sneller en gerichter handelen. Daarbij zijn vier onderdelen van belang.
Duidelijke verantwoordelijkheden
— Vastleggen wie meldingen beoordeelt, technische maatregelen uitvoert en besluiten neemt over bedrijfsprocessen.Inzicht in kritieke systemen
— Weten welke applicaties, servers, verbindingen en gegevens essentieel zijn voor de organisatie.Bereikbaarheid en escalatie
— Afspraken over wie wordt geïnformeerd, wanneer wordt opgeschaald en hoe buiten kantooruren wordt gehandeld.Herstelvoorzieningen
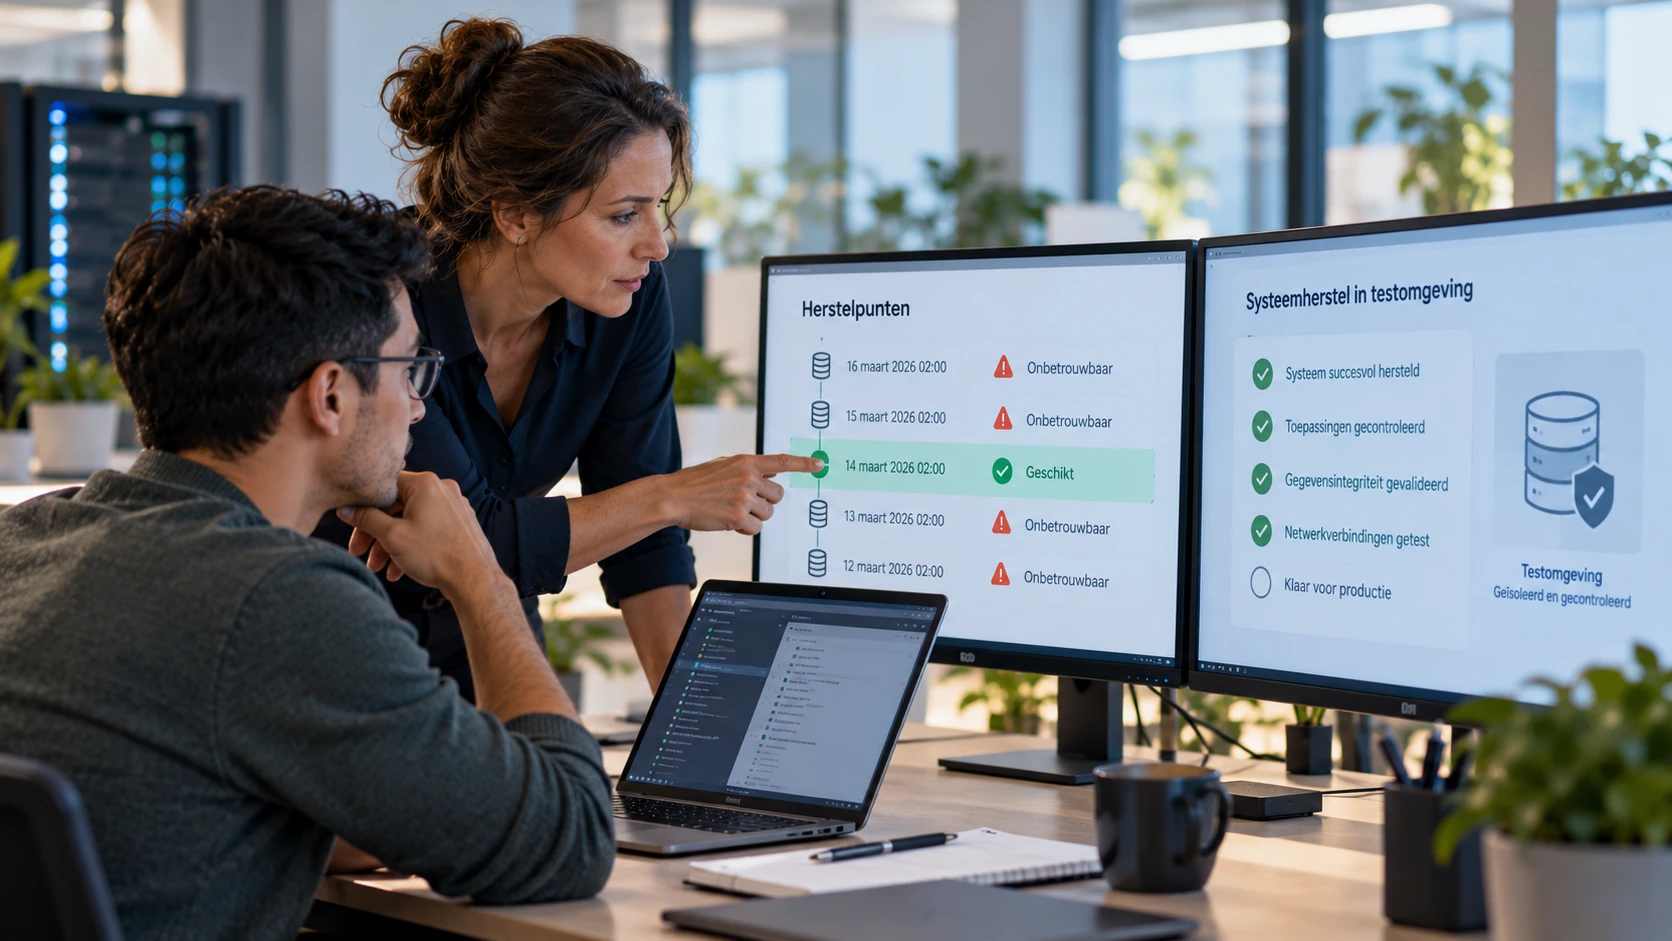
— Beschikken over betrouwbare back-ups, herstelprocedures en de middelen om systemen gecontroleerd opnieuw beschikbaar te maken.
Een incidentresponsplan hoeft niet ingewikkeld te zijn, maar moet wel bruikbaar blijven wanneer de normale werkwijze onder druk staat. Contactgegevens, bevoegdheden en herstelafspraken moeten daarom actueel zijn en regelmatig worden gecontroleerd.
Van detectie naar beheersing en herstel
Een beveiligingsincident verloopt zelden precies volgens een vooraf bedacht scenario. Toch helpt een vaste aanpak om belangrijke stappen niet over te slaan en de voortgang te bewaken.
Detecteren en beoordelen
— Onderzoeken wat er is gebeurd, welke systemen mogelijk betrokken zijn en hoe urgent de situatie is.Beperken en beheersen
— Maatregelen nemen om verdere verspreiding, onbevoegde toegang of aanvullende schade te voorkomen.Onderzoeken en herstellen
— De oorzaak vaststellen, ongewenste toegang beëindigen en systemen gecontroleerd herstellen.Evalueren en verbeteren
— Vastleggen wat er is gebeurd, welke maatregelen effectief waren en welke verbeteringen nodig zijn.
Deze stappen lopen in de praktijk regelmatig door elkaar. Terwijl de eerste systemen worden veiliggesteld, kan onderzoek uitwijzen dat ook andere onderdelen van de IT-omgeving betrokken zijn. Daarom moet de aanpak kunnen worden aangepast aan nieuwe informatie. Tegelijkertijd is het belangrijk om uitgevoerde maatregelen en bevindingen vast te leggen, zodat duidelijk blijft wat er is veranderd en welke informatie beschikbaar is voor verder onderzoek.
Uit de praktijk: een verdacht beheerdersaccount
Een beheeraccount vertoont activiteiten buiten de normale werkzaamheden
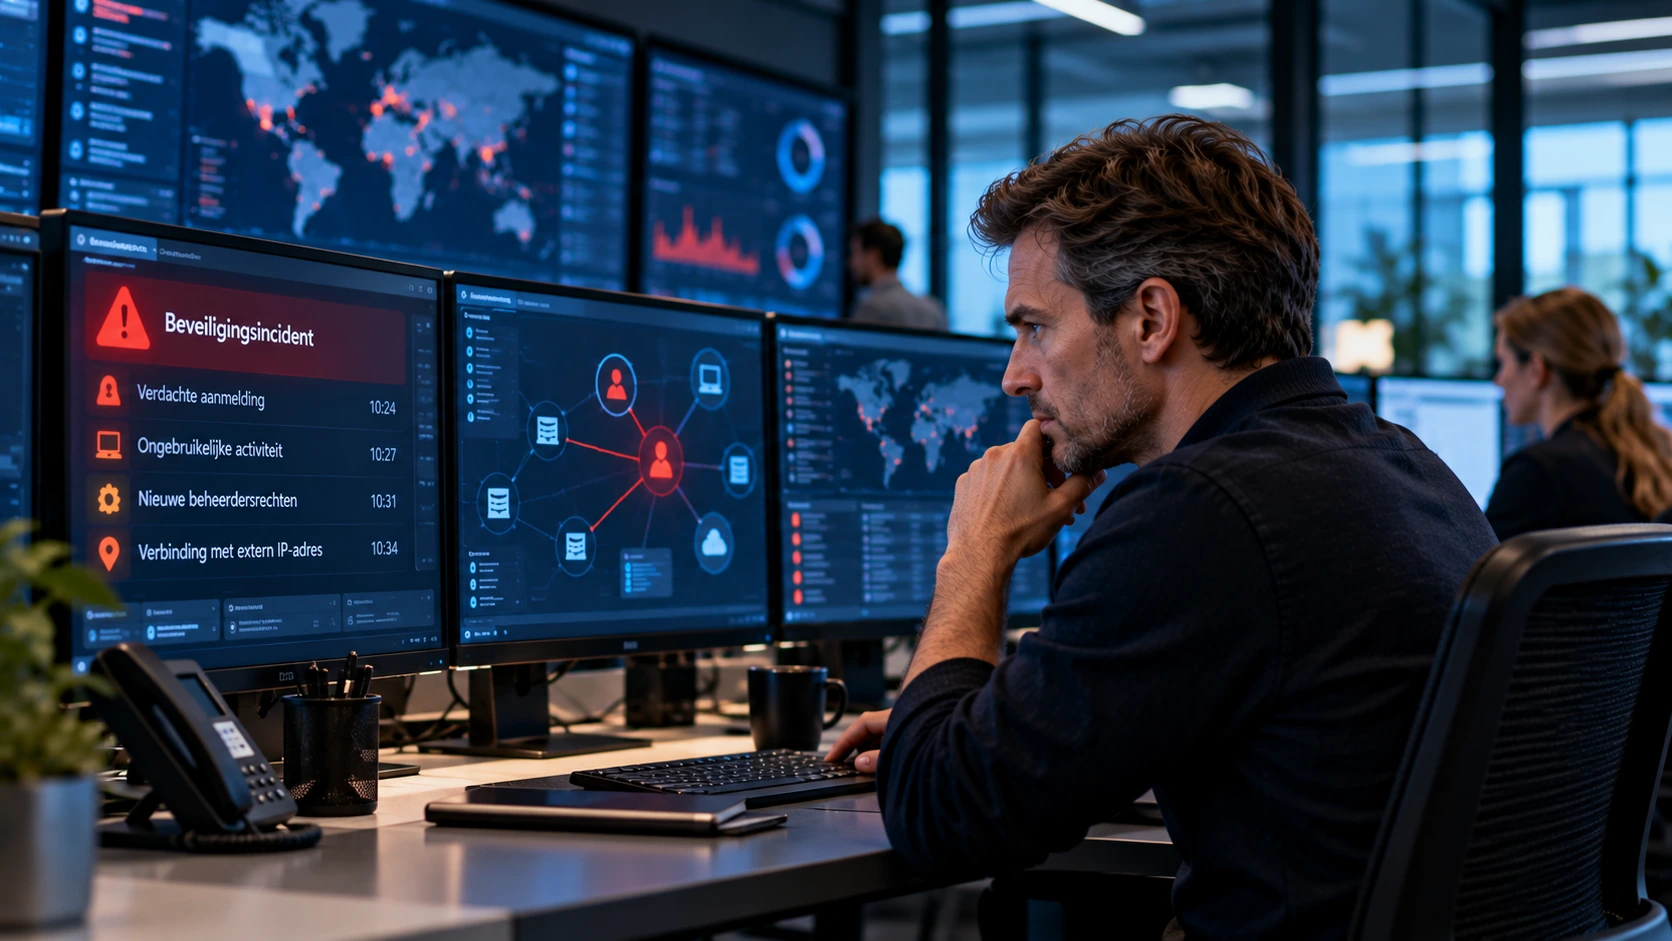
Een organisatie ontvangt een beveiligingsmelding over een beheerdersaccount dat buiten de gebruikelijke werktijden wordt gebruikt. Kort daarna worden wijzigingen in toegangsrechten geregistreerd en vinden aanmeldpogingen plaats op verschillende servers. De activiteiten kunnen afkomstig zijn van een beheerder die onderhoud uitvoert, maar omdat de wijzigingen niet overeenkomen met geplande werkzaamheden, wordt direct contact opgenomen met de verantwoordelijke IT-specialist.
Uit de eerste beoordeling blijkt dat de betreffende beheerder de activiteiten niet heeft uitgevoerd. Het account wordt geblokkeerd, actieve sessies worden beëindigd en de betrokken systemen worden onderzocht. Daarbij wordt ook gecontroleerd of andere accounts zijn aangemaakt of rechten zijn gewijzigd.
Vervolgens wordt vastgesteld welke systemen daadwerkelijk zijn benaderd en welke herstelmaatregelen nodig zijn. Pas wanneer voldoende zekerheid bestaat dat de onbevoegde toegang is beëindigd, worden de betrokken voorzieningen weer normaal beschikbaar gesteld. De snelheid waarmee het incident wordt herkend, beoordeeld en opgeschaald bepaalt mede hoe groot de gevolgen kunnen worden.
Dit is een illustratief voorbeeld, geen beschrijving van een specifiek klantincident.
Snel ingrijpen zonder de bedrijfsvoering uit het oog te verliezen
Bij een vermoedelijke aanval kan het noodzakelijk zijn om een apparaat te isoleren, een account te blokkeren of een netwerkverbinding tijdelijk uit te schakelen. Daarmee kan verdere schade worden voorkomen, maar zulke maatregelen kunnen ook bedrijfsprocessen verstoren. Het isoleren van een werkplek heeft doorgaans andere gevolgen dan het afsluiten van een server waarop de productieplanning of financiële administratie draait.
Daarom moeten vooraf afspraken worden gemaakt over de bevoegdheden van IT-beheer en beveiligingsspecialisten. Bij acute dreigingen kan onmiddellijk handelen noodzakelijk zijn, terwijl maatregelen met grote gevolgen voor de bedrijfsvoering waar mogelijk afstemming met de organisatie vereisen. Incidentrespons vraagt daarmee niet alleen om technische deskundigheid, maar ook om kennis van de bedrijfsprocessen en hun afhankelijkheden.
Hetzelfde geldt voor communicatie tijdens een incident. De directie moet weten welke processen risico lopen, medewerkers moeten kunnen beoordelen of zij veilig kunnen doorwerken en leveranciers kunnen nodig zijn voor onderzoek of herstel. Wanneer mogelijk persoonsgegevens betrokken zijn, moet bovendien worden beoordeeld of meldverplichtingen onder de AVG of andere toepasselijke regels gelden. Het is belangrijk om daarbij onderscheid te maken tussen vastgestelde feiten, vermoedens en vragen die nog onderzocht worden.
Een aanval stoppen is niet hetzelfde als herstellen
Het beëindigen van onbevoegde toegang betekent nog niet dat de organisatie veilig verder kan werken. Andersom betekent het terugzetten van een back-up niet automatisch dat de oorzaak van het incident is weggenomen.
Incidentrespons richt zich op het onder controle krijgen van de dreiging: het beveiligen van accounts, onderzoeken van verdachte wijzigingen en voorkomen van verdere schade. Herstel richt zich op het verantwoord opnieuw beschikbaar maken van systemen, applicaties en gegevens. Daarbij moet voldoende zekerheid bestaan dat de herstelomgeving betrouwbaar is en dat een aanvaller niet opnieuw toegang kan krijgen.
Beide activiteiten zijn nauw met elkaar verbonden. Wanneer systemen te snel worden hersteld zonder de oorzaak te onderzoeken, kan het incident zich herhalen. Maar langdurig onderzoek zonder duidelijke herstelprioriteiten kan eveneens grote gevolgen hebben voor de bedrijfsvoering. Een goede aanpak houdt daarom rekening met zowel beveiliging als continuïteit.
Samenwerking en verantwoordelijkheden
Niet iedere organisatie beschikt over een eigen incidentresponsteam. Vaak wordt samengewerkt met een IT-beheerder, beveiligingsspecialist of externe incidentresponspartij. Dat kan goed functioneren, mits vooraf duidelijk is wie het eerste onderzoek uitvoert, wanneer aanvullende expertise wordt ingeschakeld en wie de technische maatregelen en het herstel coördineert.
Ook moet duidelijk zijn waar de verantwoordelijkheid van een externe partij ophoudt. Een specialist kan technische risico's beoordelen en maatregelen adviseren, maar besluiten over bedrijfscontinuïteit, communicatie en het accepteren van resterende risico's vragen betrokkenheid van de organisatie zelf. Die samenwerking begint daarom niet tijdens het incident, maar bij de inrichting van het reguliere IT-beheer.
Van incident naar verbetering
Wanneer systemen weer functioneren, ontstaat de neiging om het incident af te sluiten en de normale werkzaamheden te hervatten. Toch is juist de periode na herstel belangrijk. Een evaluatie moet duidelijk maken hoe het incident kon ontstaan, welke signalen beschikbaar waren en of de opvolging goed heeft gewerkt.
Misschien bleek een beheerdersaccount te veel rechten te hebben, ontbrak monitoring op een belangrijke server of was niet duidelijk wie buiten kantooruren bereikbaar moest zijn. De bevindingen moeten worden vertaald naar concrete verbeteringen, zoals aangepaste toegangsrechten, aanvullende monitoring, wijzigingen in netwerksegmentatie of betere herstelprocedures. Ook een incident met beperkte gevolgen kan waardevolle informatie opleveren over de weerbaarheid van de organisatie.
Incidentrespons hoort bij verantwoord IT-beheer
Geen enkele beveiligingsmaatregel kan garanderen dat een incident nooit plaatsvindt. Organisaties moeten daarom niet alleen investeren in het voorkomen en herkennen van aanvallen, maar ook voorbereid zijn op situaties waarin beveiligingsmaatregelen tekortschieten.
Dat vraagt om inzicht in de IT-omgeving, duidelijke verantwoordelijkheden, deskundige opvolging en betrouwbare herstelvoorzieningen. Het verschil tussen een beheersbaar beveiligingsincident en een langdurige bedrijfsverstoring wordt niet alleen bepaald door de aanval zelf, maar ook door de manier waarop de organisatie erop reageert.